RSS 订阅订阅本栏目
共 10 篇 ← 返回全部栏目
当某个时间点、年龄或空间位置没有观测值时,插值可以根据周围的已知点,估计已知范围内的新数值。但估计值不是新观测,曲线更平滑也不代表更接近真实情况。线性、多项式、样条和径向基函数依赖不同的假设,选择时需要同时考虑数据维度、局部形态、噪声和使用目的。
面对一组彼此相关的变量,主成分分析(PCA)和因子分析都能把它们概括成更少的维度,因此常被混在一起。两者真正的区别不在于“能不能降维”,而在于研究目的:PCA用于压缩数据,因子分析用于描述多个指标背后的共同特征。本文从原理、输出、适用场景和R实现四个方面说明如何选择。
HR=0.8,能不能直接写成“疾病进展风险降低20%”?两条 Kaplan-Meier 曲线没有交叉,是否就说明比例风险假设成立?P>0.05,是否等于“没有影响”?
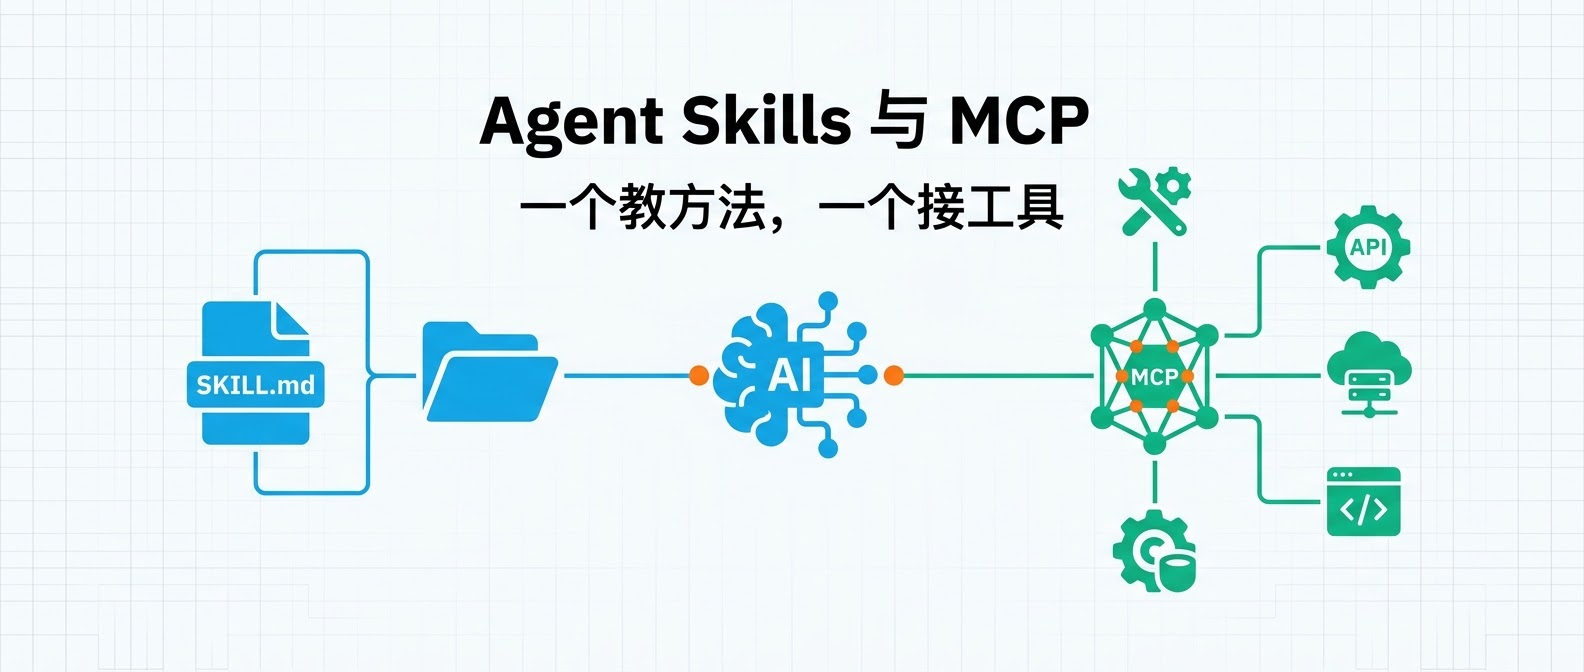
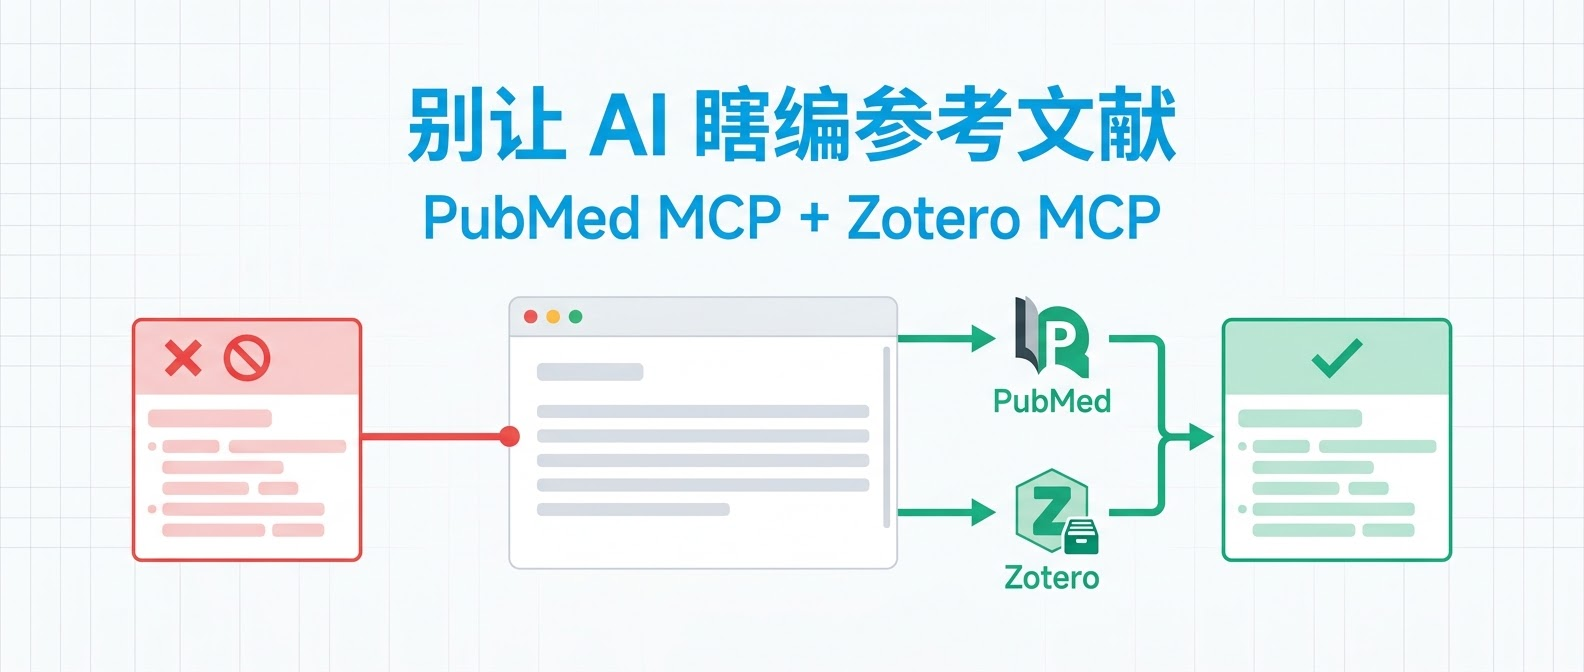
Skill 负责把经验写成程序化工作方法,MCP 负责把外部世界变成可调用接口。
不必把背语法当成入场券。但要让分析结果可信、可复核,仍然需要学会读代码、改代码和验证代码。
检索近 5 年有关“大语言模型生成医学参考文献准确性”的研究,返回查询式、PMID、DOI、题名和摘要能支持的结论。未检索到的内容不要补写。
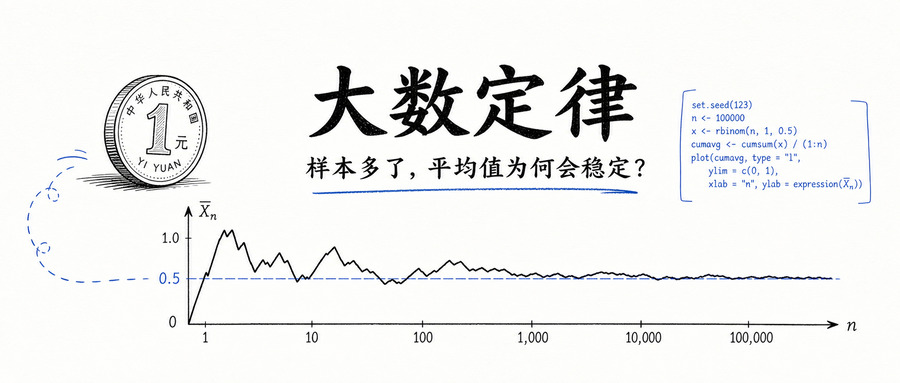
大数定律描述的是:在适当条件下,随着重复观测增多,样本平均值会逐渐靠近总体的期望值。
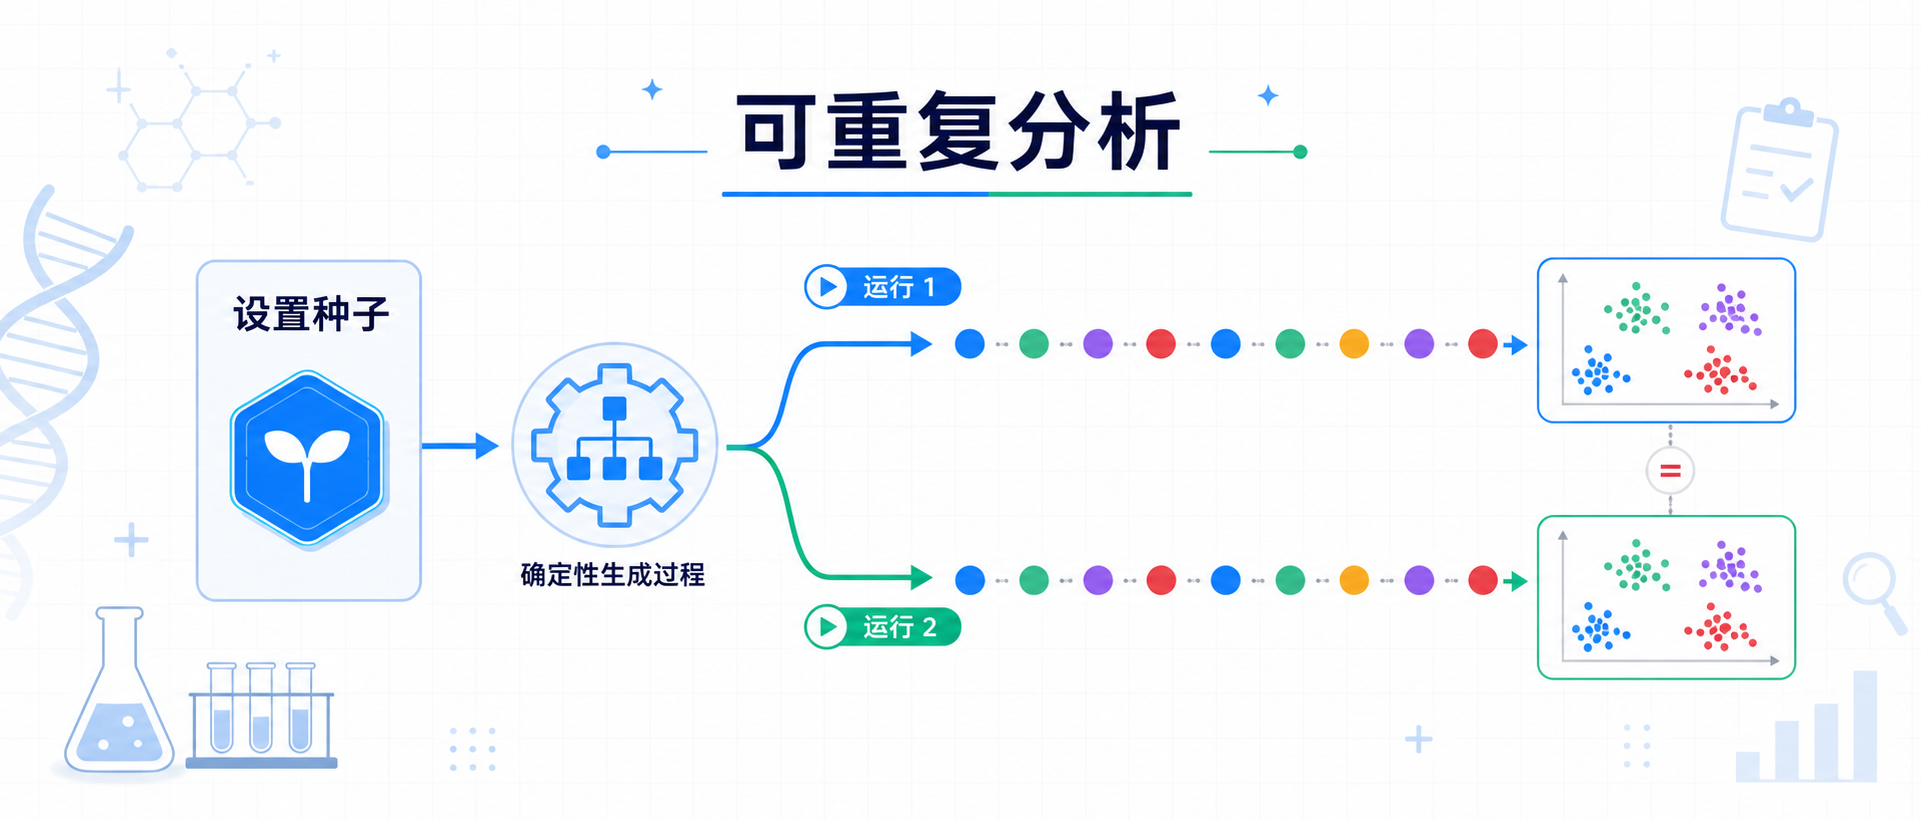
同一段抽样代码,运行两次却得到两组结果。这不一定是程序出错,很可能只是少了一行 set.seed()。
同一组数据,标准差是12,标准误却只有1.2。哪个数字更能代表数据“稳定”?先别比较大小,它们回答的不是同一个问题。
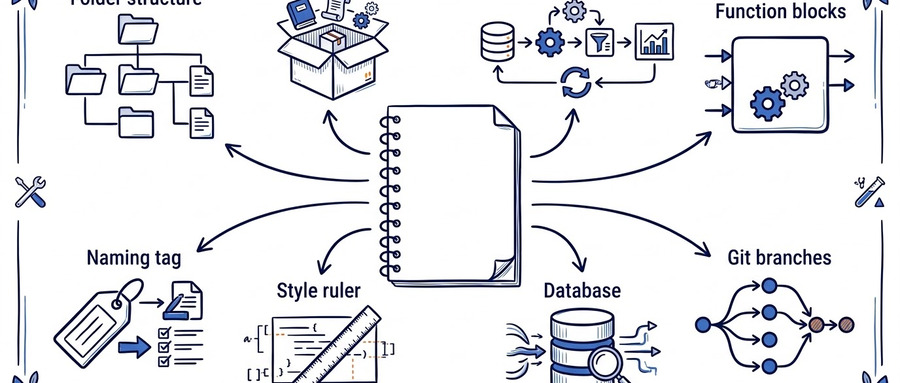
最近看到 Jacob Scott 的 R Best Practice Cheat Sheet。一张表,把项目结构、依赖管理、可复现示例、函数、命名、数据库和 Git 串了起来。很适合收藏,也值得加几条使用说明。